 同じページを何十ものファイルから取り出すのはフォルダー規模の作業です。分割ツールを備えたAIエージェントが1つのプロンプトで実行し、プロンプトが失敗リストを要求したときにファイルごとの失敗が報告されます。
 テキスト抽出はAIエージェントに文書の文字だけを渡し、レイアウトやチャート、スタンプを失います。1つのプロンプトでページを画像としてレンダリングすれば、エージェントは直接それを見ることができます。
 2つのドキュメントバージョンに関する質問の多くは、レッドラインではなく回答が必要です。GroupDocs.Comparison.Mcp の analyze_changes ツールは差分をデータとして返し、エージェントがそれを必要な要約に変換します。
 エージェントはMarkdownを書きますが、ステークホルダーはPDFとWordを読みます。実際のレイアウトエンジンとブラウザやLaTeXツールチェーンを使用しない二段階プロンプトでギャップを埋めます。
 クラウドアシスタントに写真の内容を尋ねると、確認したい位置情報を含む写真を送信する必要があります。GroupDocs.Metadata.Mcp は、ローカルマシン上で EXIF、XMP、IPTC をその場で読み取ります。
 エラーなく実行されたレダクションツールは、データが消えたことを証明したわけではありません。リリースしようとしているファイルに対してエージェントが実行する短い検証ループが、主張を証拠に変えます。
 「DRAFT を取り除く」ようなプロンプトは重要な問いを飛ばします:ファイルが実際に何を保持しているか? まず検索することで、盲目的な削除を自分のドキュメントの監査に変えます。
 チャート、スタンプ、スキャンページには、テキスト抽出では決して見えない答えが含まれています。ページをレンダリングし、画像を視覚対応モデルに渡すことでそれらにアクセスできますが、精度には正直な限界があります。
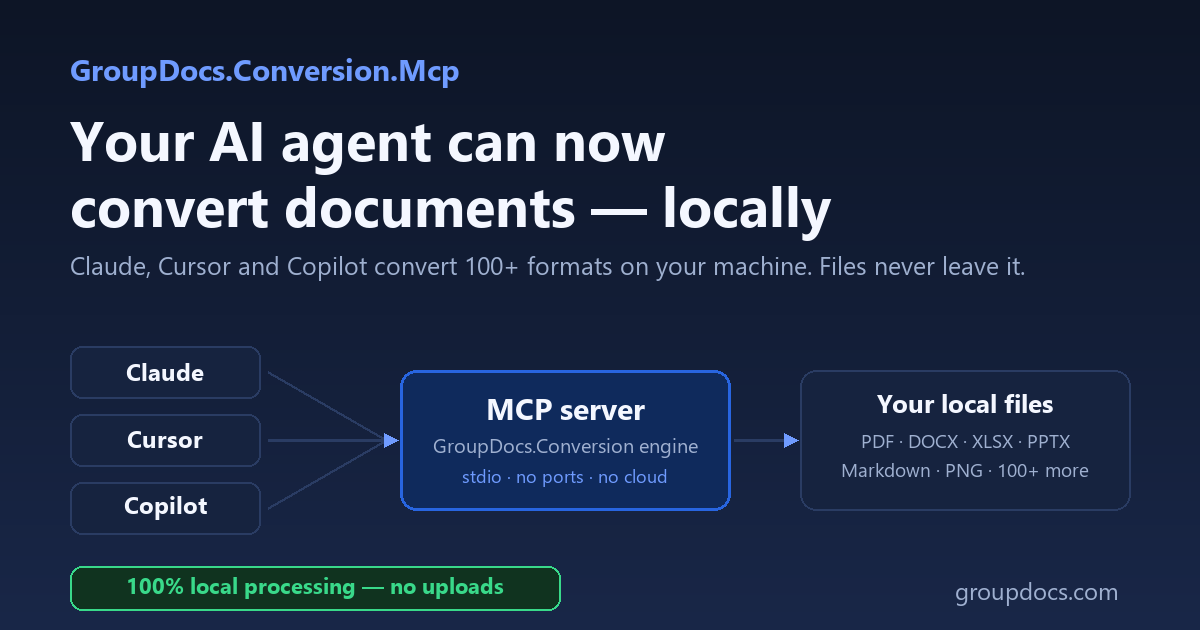 1 つのコマンドで MCP サーバーをインストールし、Claude、Cursor、Copilot に完全な GroupDocs.Conversion エンジンを提供します — 100 以上のフォーマットがマシン上で変換され、どこにもアップロードされません。