הבעיה בהשוואת שני סריקות
הדפסו דף, סרקו אותו, ערכו מילה אחת, הדפיסו וסקרו שוב. עכשיו השוו בין שתי התמונות.
שום דבר אינו מתיישר. הסריקה השנייה יושבת שני מילימטרים נמוך יותר, השוליים מוטים בכמה פיקסלים, ריווח השורות השתנה. השוואת פיקסלים מדווחת במדויק על מה שהיא רואה: כמעט כל שורה שונה. במקום כלשהו בתוצאה יש את המילה שהשתנתה, ואף מבקר לא ימצא אותה.
זה אינו פגם בהשוואת פיקסלים – היא משיבה על השאלה שנשאלה. הבעיה היא שהשאלה הייתה שגויה. אף אחד לא רוצה לדעת אילו פיקסלים שונים בין שתי סריקות. הם רוצים לדעת אילו מילים שונות.
GroupDocs.Comparison for .NET 26.10 מוסיף השוואת תמונות מבוססת OCR, השואלת את השאלה הנכונה. הוא קורא את הטקסט משתי התמונות ומשווה ביניהם במקום זאת.
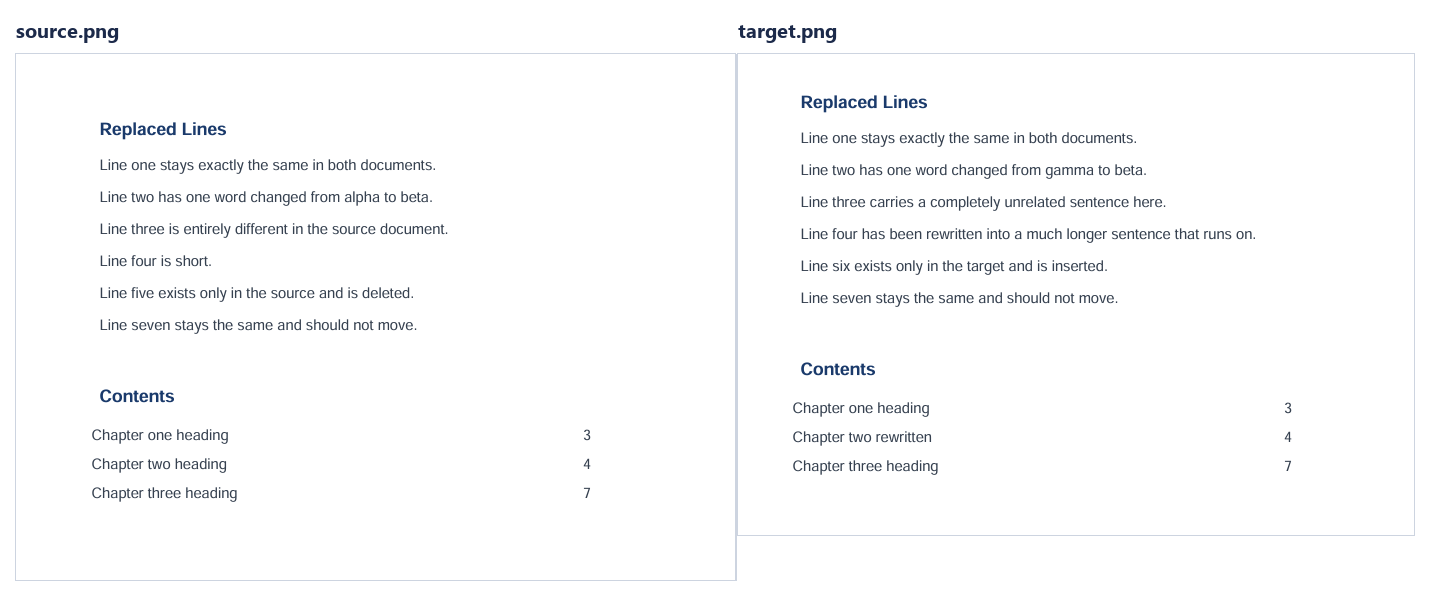
להלן שתי התמונות שהמאמר משווה לאורך כל הדרך. שבע מילים שונות ביניהן, וכל בלוק הטקסט נמצא במיקום שונה בכל אחת – היעד מוזז למעלה ולשמאלה, בדיוק כפי שסורק מחדש היה עושה:
מהי השוואת תמונות מבוססת OCR?
השוואת תמונות מבוססת OCR משווה בין שתי תמונות על פי הטקסט שהזוהה בהן במקום על פי הפיקסלים. כל תמונה נקראת על ידי מנוע זיהוי, ורצפי המילים המתקבלים מושווים. מכיוון שהיחידה של ההשוואה היא מילה ולא פיקסל, טקסט שהזיז רק את מיקומו בין שתי סריקות נחשב ללא שינוי, ורק ניסוח שונה באמת מדווח כשינוי.
הפעלת התכונה
One property:
using var comparer = new Comparer("documents/source.png");
comparer.Add("documents/target.png");

comparer.Compare("Result/compared.png", new CompareOptions
{
    Ocr = new OcrOptions { Enabled = true },
    GenerateSummaryPage = false,
});

Console.WriteLine($"Changes: {comparer.GetChanges().Length}");
זהו כל האינטגרציה. Enabled מוגדר כברירת מחדל ל-false, ולכן כל השוואה קיימת בקוד שלכם מתנהגת בדיוק כפי שהייתה – אפילו אם מועברת לה מופעת OcrOptions מבלי להפעילה.
שתי דברים שכדאי לדעת לפני הריצה. דרישת החבילה היא 26.10.0 או מאוחר יותר, מכיוון שהתכונה אינה קיימת לפני כן. והיא דורשת יעד של .NET Core: מנוע הזיהוי מספק את זמן הריצה הטבעי שלו רק עבור .NET Core ומעלה, ולכן בקשת OCR על .NET Framework תגרום ל-NotSupportedException במקום לכשל באופן בלתי ברור בתוך המנוע.
מה שהיא לא צריכה הוא חבילה שנייה. מנוע ה-OCR מגיע כתלות משנית של GroupDocs.Comparison, ולכן dotnet add package וזהו.
מה מחזיר
הרצת הקטע שלמעלה נגד שני רינדורים מכוילים בכוונה של אותה העמוד – אחד עם מילה מוחלפת, שורה משוכתבת, שורה נמחקת, שורה מוכנסת וכותרת שונתה בתוכן העניינים – מחזירה שבעה שינויים. לא שבע מאות. שבעה, ברמת אמון זיהוי בין 0.97 ל‑1.00:
Modified: 'alpha' -> 'gamma'                        (confidence 0.98)
Modified: 'is short.' -> 'has been rewritten ...'   (confidence 0.99)
Modified: 'five' -> 'six'                           (confidence 0.99)
Modified: 'heading' -> 'rewritten'                  (confidence 1.00)
כל בלוק הטקסט נמצא במיקום שונה בכל עמוד, ואף אחד מהמיקומים הללו אינו מופיע בתוצאה. מילה שהוזזה בלבד נשארת אותה מילה.
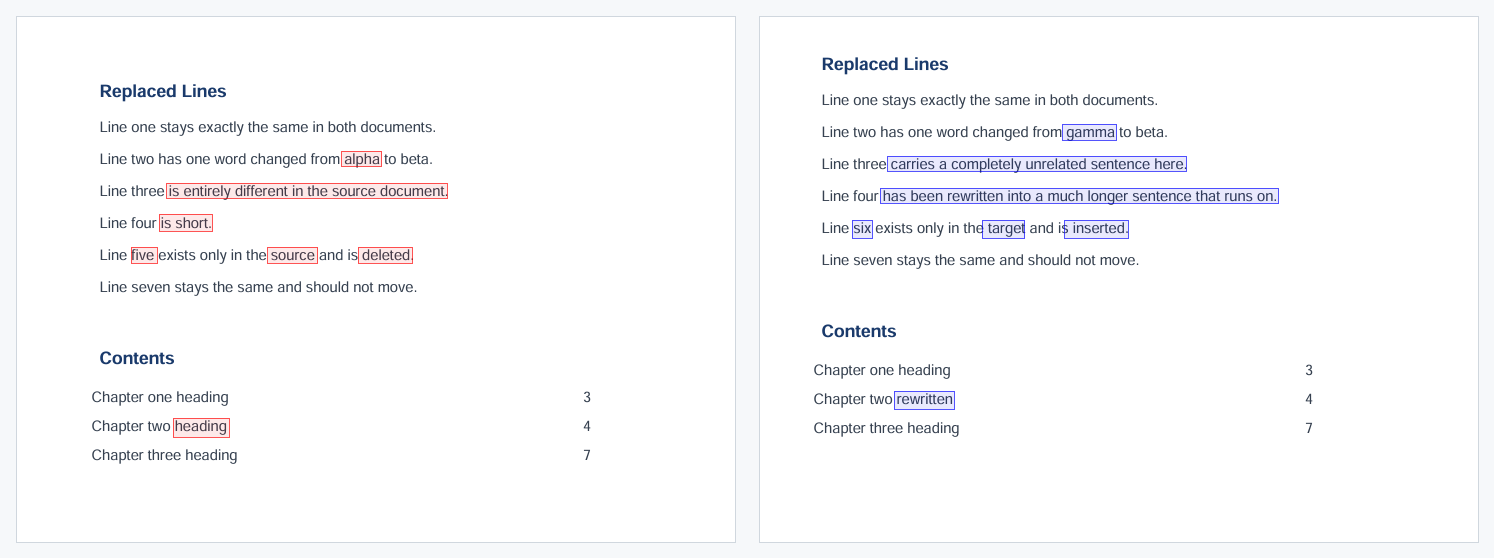
שני העמודים שומרים על הפריסה שלהם, וכל מילה שהשתנתה מסומנת במקום שבו היא נמצאת: אדום למה שהמקור אומר, כחול למה שהיעד אומר. “Line seven stays the same and should not move” אינו מסומן באף צד, למרות שמדובר במספר פיקסלים שונה למטה בכל עמוד.
בחירת אופן הצגת התוצאה
OcrDisplayMode מכיל שני ערכים, והבחירה נוגעת לקהל היעד ולא להשוואה עצמה.
SideBySide הוא ברירת המחדל. הוא משחזר את שני העמודים בפריסתם המקורית ומסמן כל מקום שבו הם שונים זה מזה – גופנים, טבלאות, עמודות ותמונות נשמרים. זה מה שמאשר אנושי רוצה: הסעיף שהשתנה במיקום שלו בחוזה.
Ocr = new OcrOptions
{
    Enabled = true,
    DisplayMode = OcrDisplayMode.SideBySide,
},
Text מציג את המילים שהזוהו משני המסמכים כזרם יחיד עם מחיקות והוספות מודגשות, ללא שימור של הפריסה המקורית. קובץ התוצאה יצא בגודל של כ‑¼ מהקובץ במצב side‑by‑side בריצה לדוגמה. הוא מתאים ליומן ביקורת, למייל סיכום, או לכל מקום שבו הניסוח חשוב והעיצוב של העמוד אינו.
Ocr = new OcrOptions
{
    Enabled = true,
    DisplayMode = OcrDisplayMode.Text,
},
שבעת העריכות מאותו זוג תמונות, מוצגות כזרם אחד – מילים שהוסרו באדום, מילים שהוכנסו בכחול, צמודות כך שההחלפה נראית במבט אחד:
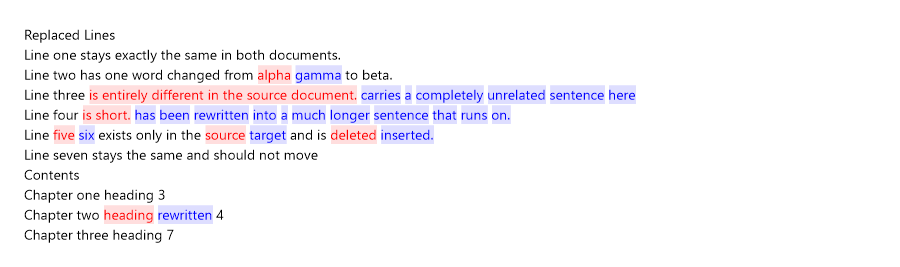
שני המצבים מוצאים את אותם עריכות. המצב קובע איך התוצאה מוצגת, ולא מה ההשוואה מוצאת – הבחנה שכדאי לשמור, מכיוון שהיא מאפשרת להחליף פורמט פלט ללא צורך לאמת מחדש את זיהוי השינויים.
שפות
OcrLanguage מכיל 154 ערכים. אלפבית יחיד (Deu, Rus, Jpn, Spa), מודלים לכל הכתיבה (Cyrillic, Chinese, Indic, PersoArabic), ו‑Auto לזיהוי כאשר המסמכים מעורבים או לא ידועים.
Ocr = new OcrOptions
{
    Enabled = true,
    Language = OcrLanguage.Cyrillic,
},
ברירת המחדל היא Latin, וברירת המחדל הזו חשובה תפעולית: Latin הוא המודל היחיד בתוך החבילה. כל ערך אחר דורש מודל שמורד ממאגר Aspose.OCR בפעם הראשונה ומשמר במטמון מקומי. ציון הכתיבה שהמסמכים שלכם משתמשים בה קורא את התווים שלהם בצורה מדויקת יותר ממודל כללי, ולכן כדאי להגדיר זאת כשאתם יודעים זאת.
קריאת מיקום השינויים
תמונה ציד-ציד מספיקה כאשר אדם מביט בה. כאשר היישום מצייר שכבה משלו – ממשק ביקורת, כלי סימון, מציג diff – הוא זקוק לקואורדינטות.
- זה צריך קואורדינטות.
foreach (ChangeInfo change in comparer.GetChanges())
{
    if (change is not OcrChangeInfo ocrChange)
    {
        continue;
    }

    Console.WriteLine($"{ocrChange.Type}: '{ocrChange.SourceText}'"
        + $" -> '{ocrChange.TargetText}'"
        + $" (confidence {ocrChange.Confidence:F2})");

    foreach (Rectangle box in ocrChange.TargetBoxes)
    {
        Highlight(box.X, box.Y, box.Width, box.Height);
    }
}
GetChanges() מוגדר כ‑ChangeInfo[], ולכן פרטי ה‑OCR דורשים המרה ל‑OcrChangeInfo. תת‑הסוג מוסיף SourceBoxes ו‑TargetBoxes – ריבוע אחד לכל שורת טקסט, בפיקסלים של התמונה של אותה צד, עם קואורדינטות מסוג float – ו‑Confidence בין 0 ל‑1.
ערך האמון הוא שימושי יותר ממה שנראה במבט ראשון. רישומו לצד כל שינוי מאפשר לצינור להעביר כל דבר שמתחת לסף לביקורת ידנית במקום להתייחס לכל הטקסט המזוהה כאמין באותה מידה.
הרצה ללא רשת
סוכן בנייה או מארח מבודד לא צריכים לנסות הורדה בלתי מודעת של מודל זיהוי. שתי תכונות מונעות זאת:
Ocr = new OcrOptions
{
    Enabled = true,
    Language = OcrLanguage.Latin,
    DisableResourceDownloads = true,
    ResourcesPath = "/opt/ocr-models",
},
DisableResourceDownloads הופך מודל חסר לשגיאה במקום לנסות להוריד אותו שיתקע או יידחה לחלוטין. ResourcesPath מציין את התיקייה שממנה מודלים נקראים ונשמרים במטמון.
שניהם חלים על כל התהליך ולא על קריאה בודדת, ולכן יש להגדירם פעם אחת בזמן האתחול ולא בכל השוואה – פרט שקל לפספס כאשר אובייקט האפשרויות נבנה לכל בקשה.
טקסט ב‑Latin עובד ללא חיבור אינטרנט וללא הכנה, מכיוון שהמודל הזה נכלל בחבילה. עבור כל כתיבה אחרת, העתקו את תיקיית המודל המוטמנת ממחשב שהוריד אותה פעם אחת והצביעו ResourcesPath אליה.
טיפול בכשלים שכדאי לטפל בהם
שני מצבי כשל ראויים לטיפול מפורש במקום לתפוס הכל באופן כללי.
הראשון הוא של הפלטפורמה. אם כל נתיב קוד יכול להגיע להשוואת OCR מיעד .NET Framework, הוא יזרוק NotSupportedException, ותפיסתו באופן ספציפי מאפשרת לרשום משהו שמתחזק יכול לפעול עליו במקום עקבות מחסנית מתוך המנוע.
השני הוא מודל שלא קיים. עם DisableResourceDownloads מופעל, שפה שהמודל שלה לא נשמר במטמון תיכשל במקום לנסות להוריד – זהו המטרה של ההגדרה, אך היא מסייעת רק אם השגיאה ניתנת לזיהוי. המנוע מדווח על כך דרך שרשרת החריגות, ולכן יש לבדוק את InnerException בנוסף להודעה החיצונית כאשר מחליטים אם הכשל נוגע למודל או להשוואה עצמה.
try
{
    comparer.Compare(outputPath, options);
}
catch (NotSupportedException)
{
    logger.LogError("OCR comparison needs a .NET Core-era runtime.");
    throw;
}
אף מקרה אינו יוצא דופן. הראשון מתרחש כאשר ספרייה משותפת בין שירות מודרני למארח ישן; השני, בפעם הראשונה שהפריסה רצה במקום שבו המטמון לא הועתק.
הערה על איכות התמונה
דיוק הזיהוי קובע את התקרה של דיוק ההשוואה, ושום דבר בהשוואה אינו יכול לשחזר טקסט שהמנוע קרא באופן שגוי. זוג הדוגמאות כאן נקי – טקסט מרונדר, ניגוד גבוה, ללא עיוות – ומחזיר ערכים בין 0.97 ל‑1.00. סריקות אמיתיות של נייר ישן לא תמיד יגיעו לכך.
זהו הטיעון המעשי לרשום את Confidence במקום לזרוק אותו. שינוי המדווח ב‑0.6 אינו בהכרח שגוי, אך הוא סוג טענה שונה מזה שב‑0.99, וצינור שמטפל בהם באופן זהה יחשוף בסופו של דבר ארטיפקט זיהוי כעריכת מסמך. קביעת סף על האמון והפניית מה שנופל מתחתיו לאדם, הוא בעל עלות נמוכה ומשאיר זאת מחוץ לתוצאה.
מתי להשתמש בזה
השוואת OCR היא הכלי הנכון כאשר המסמכים הגיעו כתמונות והשאלה היא לגבי ניסוחם: חוזים סרוקים, חשבוניות משומרות, תיקונים שנשלחו בפקס, צילומי מסך של דוח משתי בניות שונות. בכל מקום שבו שני רינדורים של אותו תוכן לא יתאימו לפיקסל.
זה אינו תחליף להשוואת מסמכים שכבר יש לכם כטקסט. אם שני הצדדים הם DOCX או PDF עם שכבת טקסט אמיתית, השוו אותם ישירות – הטקסט כבר קיים, והזיהוי רק יוסיף שלב ומקור לשגיאה.
התחילו עם Enabled = true והברירות המחדל, הריצו זאת נגד זוג עמודים שבהם אתם יודעים מה השתנה, ובדקו שהמספר תואם. לאחר מכן הוסיפו בחירת שפה וטיפול בקואורדינטות לפי הצורך של היישום.