比较两次扫描的难题
打印一页,扫描它,编辑一个单词,再打印并再次扫描。现在比较这两张图像。
没有任何对齐。第二次扫描低了两毫米,边距偏移了几像素,行间距也漂移了。像素比较忠实地报告它看到的内容:几乎每一行都不同。输出中某处包含了那个被改动的单词,但没有审阅者会去找它。
这不是像素比较的缺陷——它在回答它被问到的问题。问题在于提问方式错误。没有人想知道两次扫描之间哪些像素不同,他们想知道哪些单词不同。
GroupDocs.Comparison for .NET 26.10 添加了基于 OCR 的图像比较,能够提出正确的问题。它读取两张图像中的文本并进行比较。
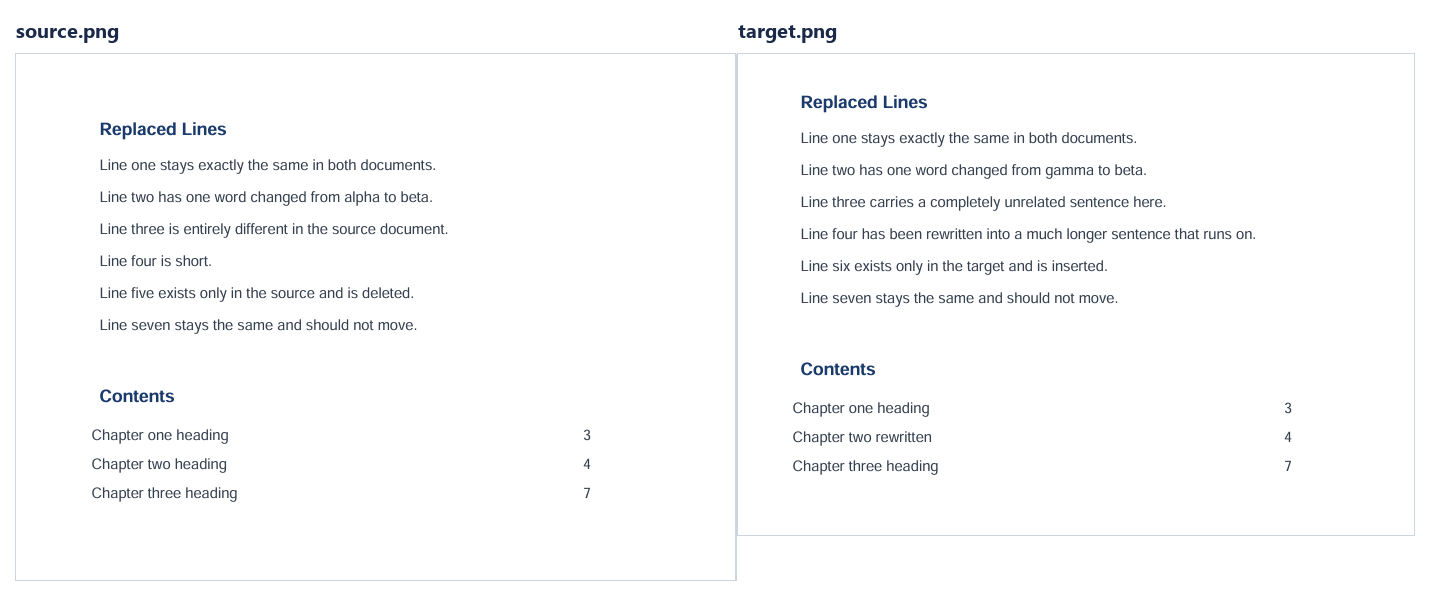
下面的两张图像是本文贯穿使用的示例。它们之间有七个单词不同,并且整个文本块在每张图像中的偏移位置也不同——目标图像向上左侧移动,正如重新扫描的效果:
什么是基于 OCR 的图像比较?
基于 OCR 的图像比较不是通过像素,而是通过图像中识别出的文本来比较两张图像。每张图像都会被识别引擎读取,得到的单词序列随后进行比较。由于比较单元是单词而不是像素,文本在两次扫描之间仅仅位置移动时会被视为未改变,只有真正的文字差异才会被报告为更改。
启用方式
一个属性:
using var comparer = new Comparer("documents/source.png");
comparer.Add("documents/target.png");

comparer.Compare("Result/compared.png", new CompareOptions
{
    Ocr = new OcrOptions { Enabled = true },
    GenerateSummaryPage = false,
});

Console.WriteLine($"Changes: {comparer.GetChanges().Length}");
这就是全部集成代码。Enabled 默认是 false,因此你代码库中已有的比较行为保持不变——即使传入了 OcrOptions 实例而没有打开它。
在运行之前有两点需要了解。包的最低版本要求是 26.10.0 或更高,因为该功能在此之前不存在。并且它需要 .NET Core 时代的目标运行时:识别引擎仅为 .NET Core 及以后提供原生运行时,所以在 .NET Framework 上请求 OCR 会抛出 NotSupportedException,而不是在引擎内部模糊失败。
它不需要第二个包。OCR 引擎作为 GroupDocs.Comparison 的传递依赖自动到达,所以只需 dotnet add package,别无他需。
返回的结果
将上面的代码片段运行在两张刻意错位的同一页面渲染上——其中一张包含单词替换、行重写、行删除、行插入以及目录标题更改——会返回七个更改。不是七百个。七个,置信度在 0.97 到 1.00 之间:
Modified: 'alpha' -> 'gamma'                        (confidence 0.98)
Modified: 'is short.' -> 'has been rewritten ...'   (confidence 0.99)
Modified: 'five' -> 'six'                           (confidence 0.99)
Modified: 'heading' -> 'rewritten'                  (confidence 1.00)
整个文本块在每页上的偏移位置不同,但该偏移并未出现在输出中。仅仅移动位置的单词仍然被视为相同单词。
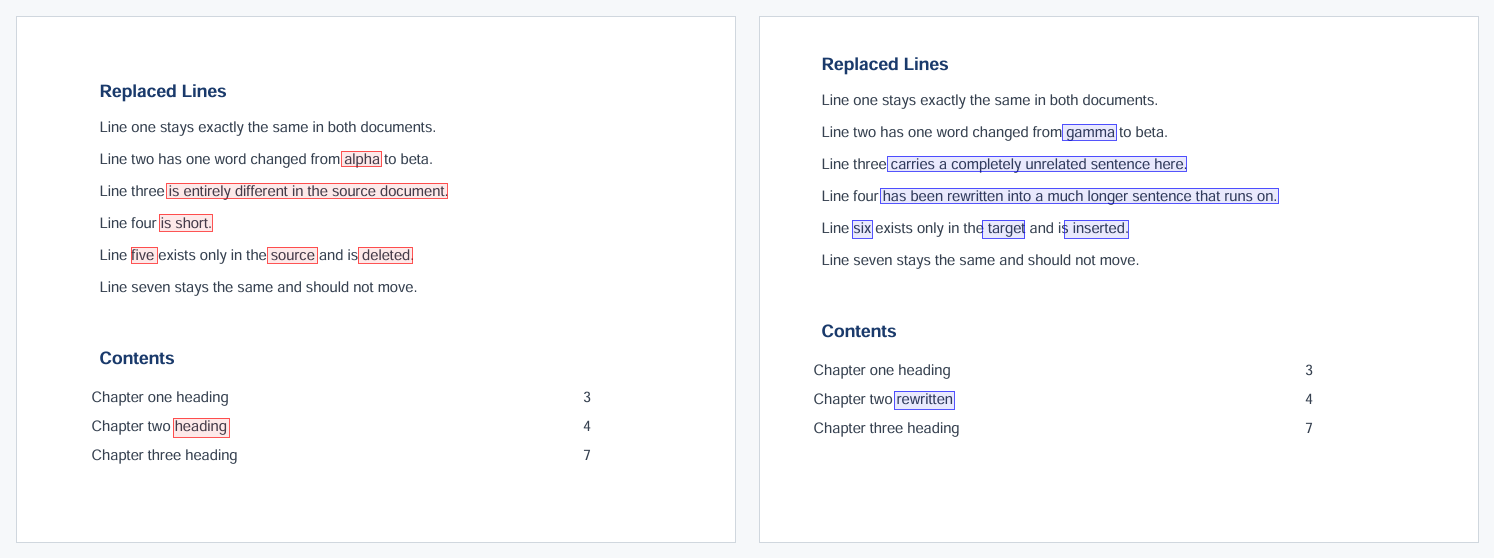
两页各自保持自己的布局,每个更改的单词都在其所在位置被框住:源文红框,目标文蓝框。“第七行保持不变且不应移动”在两侧都没有标记,尽管它在每页的像素位置不同。
选择结果的绘制方式
OcrDisplayMode 有两个取值,选择取决于受众而非比较本身。
SideBySide 是默认值。它以原始布局呈现两页,并在每处差异处标记——字体、表格、列和图像保持完整。这正是人工审阅者想要的:在合同所属的段落中看到被修改的条款。
Ocr = new OcrOptions
{
    Enabled = true,
    DisplayMode = OcrDisplayMode.SideBySide,
},
Text 将两份文档的识别单词渲染为单一流,并以删除和插入的方式高亮,完全不保留原始布局。示例运行中生成的文件大小约为并排模式的四分之一。它适用于审计日志、摘要邮件,或任何文字重要而页面设计不重要的场景。
Ocr = new OcrOptions
{
    Enabled = true,
    DisplayMode = OcrDisplayMode.Text,
},
同样的七处编辑,来自同两张图像,绘制为单一流——删除的单词用红色标记,插入的单词用蓝色标记,紧邻排列,使得替换一目了然:
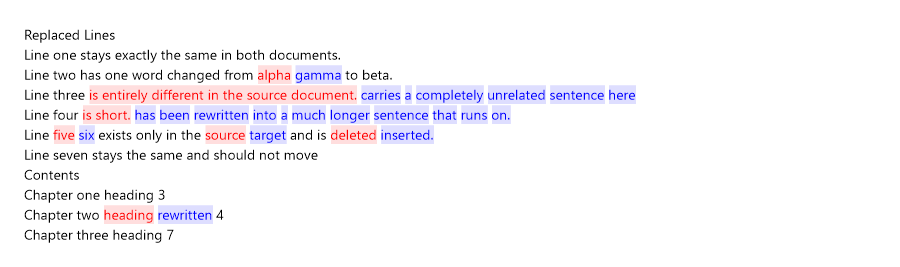
两种模式发现的编辑相同。模式决定结果的呈现方式,而不是比较的发现——这一点值得记住,因为它意味着你可以在不重新验证更改检测的前提下切换输出格式。
语言
OcrLanguage 包含 154 个取值。单一字母表(Deu、Rus、Jpn、Spa),全脚本模型(Cyrillic、Chinese、Indic、PersoArabic),以及在文档混合或未知时使用的 Auto。
Ocr = new OcrOptions
{
    Enabled = true,
    Language = OcrLanguage.Cyrillic,
},
默认是 Latin,这个默认在实际运行中很重要:Latin 是包内唯一自带的模型。其他所有取值首次使用时都需要从 Aspose.OCR 仓库下载模型并在本地缓存。使用文档实际使用的脚本名称可以更准确地识别字符,因此在已知时值得进行设置。
读取更改所在位置
当有人肉查看时,侧并排图像已经足够。当应用自行绘制覆盖层——审阅 UI、红线工具、差异查看器——时则需要坐标。
- 它需要坐标。
foreach (ChangeInfo change in comparer.GetChanges())
{
    if (change is not OcrChangeInfo ocrChange)
    {
        continue;
    }

    Console.WriteLine($"{ocrChange.Type}: '{ocrChange.SourceText}'"
        + $" -> '{ocrChange.TargetText}'"
        + $" (confidence {ocrChange.Confidence:F2})");

    foreach (Rectangle box in ocrChange.TargetBoxes)
    {
        Highlight(box.X, box.Y, box.Width, box.Height);
    }
}
GetChanges() 的返回类型是 ChangeInfo[],因此 OCR 细节需要强制转换为 OcrChangeInfo。该子类型额外提供 SourceBoxes 和 TargetBoxes——每行文本对应一个矩形,坐标以该侧图像的像素为单位,使用浮点数——以及 0 到 1 之间的 Confidence。
置信度值的价值超出表面。将其记录在每个更改旁边,可让流水线将低于阈值的项路由至人工复审,而不是把所有识别文本都视为同等确定。
在无网络环境下运行
构建代理或空气隔离的主机不应在未声明的情况下下载识别模型。两个属性可以阻止这种情况:
Ocr = new OcrOptions
{
    Enabled = true,
    Language = OcrLanguage.Latin,
    DisableResourceDownloads = true,
    ResourcesPath = "/opt/ocr-models",
},
DisableResourceDownloads 会把缺失的模型转为错误,而不是导致卡住或被直接拒绝的下载。ResourcesPath 指定模型读取和缓存的文件夹路径。
这两个设置作用于整个过程,而不是单次调用,所以应在启动时设置一次,而不是在每次比较时都设置——这是在每次请求构造选项对象时容易遗漏的细节。
拉丁文文本离线即可使用,无需任何准备,因为该模型随包一起提供。对于其他脚本,只需从已经下载过模型的机器复制缓存的模型文件夹,并将 ResourcesPath 指向该位置。
处理值得处理的失败情况
有两种失败模式需要显式处理,而不是统一捕获。
第一种是平台相关。如果任何代码路径在 .NET Framework 目标上尝试 OCR 比较,都会抛出 NotSupportedException,专门捕获它可以记录可供维护者处理的信息,而不是来自引擎内部的堆栈跟踪。
第二种是模型缺失。开启 DisableResourceDownloads 后,未缓存的语言模型会直接报错而不是尝试下载——这正是该设置的目的,但只有在错误能够被识别时才有帮助。引擎会通过异常链报告此类错误,因此在判断是模型问题还是比较本身的问题时,需要检查 InnerException 以及外层消息。
try
{
    comparer.Compare(outputPath, options);
}
catch (NotSupportedException)
{
    logger.LogError("OCR comparison needs a .NET Core-era runtime.");
    throw;
}
这两种情况都不算罕见。第一种出现在库在现代服务和传统主机之间共享时;第二种则在首次部署到未复制缓存的环境时出现。
关于图像质量的说明
识别准确度决定了比较准确度的上限,比较过程无法恢复引擎误读的文本。这里使用的示例对是一张干净的渲染文本,高对比度,无倾斜,置信度在 0.97 到 1.00 之间。老旧纸质文档的实际扫描未必能达到此水平。
这正是记录 Confidence 而不是直接丢弃的实际理由。置信度为 0.6 的更改不一定错误,但它的可信度与 0.99 的不同,若流水线对两者一视同仁,最终会把识别误差误当作文档编辑。对置信度进行阈值过滤,并将低于阈值的项交给人工处理,成本低且能把误差排除在输出之外。
何时使用此功能
当文档以图像形式到达且关注点在文字内容时,OCR 比较是合适的工具:扫描的合同、归档的发票、传真修改、不同构建的报告截图等。只要是同一内容的两次渲染无法在像素层面对齐,都适用。
它并不是替代已经是文本的文档比较。如果双方都是 DOCX 或 PDF 并且包含真实的文本层,直接比较文本即可——文字已经存在,使用 OCR 只会增加一步并引入潜在错误。
先将 Enabled = true 与默认设置打开,对一对已知更改的页面运行,检查返回的计数是否匹配。随后根据应用需求添加语言选择和坐标处理。