Masalah Membandingkan Dua Pemindaian
Cetak sebuah halaman, pindai, edit satu kata, cetak dan pindai lagi. Sekarang bandingkan dua gambar tersebut.
Tidak ada yang sejajar. Pemindaian kedua berada dua milimeter lebih rendah, marginnya tergeser beberapa piksel, jarak barisnya berubah. Perbandingan piksel dengan setia melaporkan apa yang dilihatnya: hampir setiap baris berbeda. Di antara output itu ada satu kata yang berubah, dan tidak ada peninjau yang akan menemukannya.
Ini bukan cacat pada perbandingan piksel – itu menjawab pertanyaan yang diajukan. Masalahnya pertanyaannya salah. Tidak ada yang ingin tahu piksel mana yang berbeda antara dua pemindaian. Mereka ingin tahu kata mana yang berbeda.
GroupDocs.Comparison untuk .NET 26.10 menambahkan perbandingan gambar berbasis OCR, yang mengajukan pertanyaan yang tepat. Ia membaca teks dari kedua gambar dan membandingkannya sebagai gantinya.
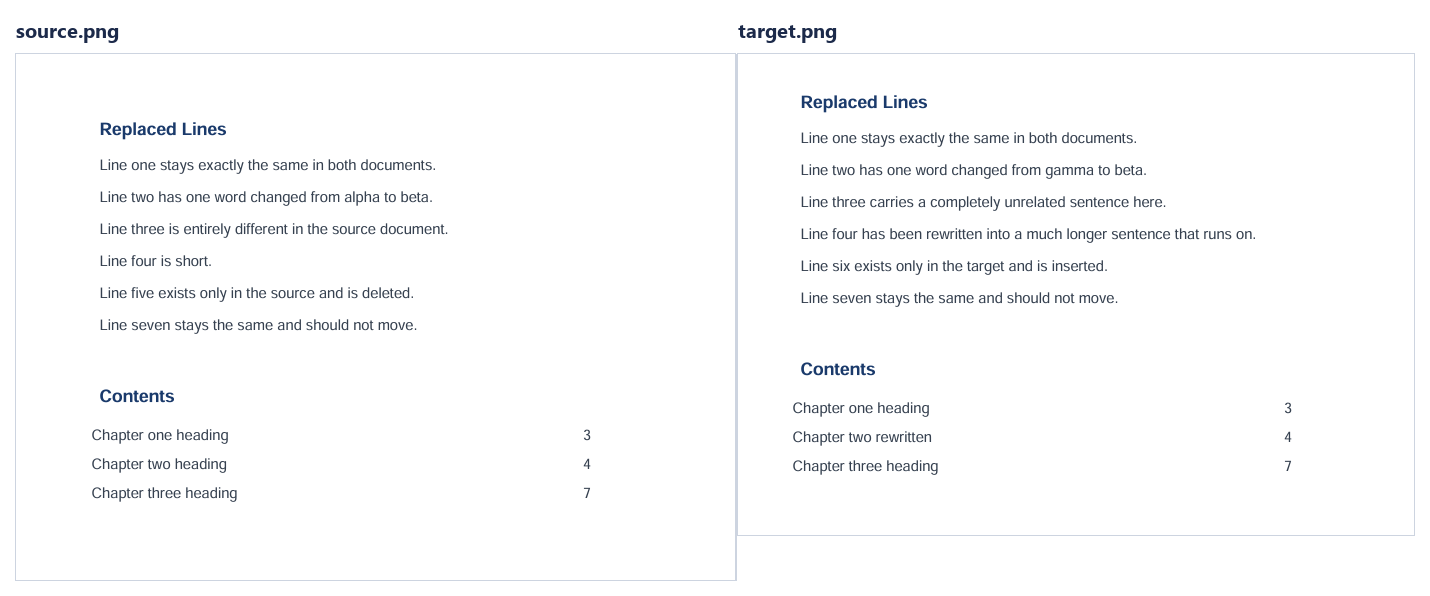
Berikut dua gambar yang dibandingkan dalam artikel ini. Tujuh kata berbeda di antara keduanya, dan seluruh blok teks berada pada offset yang berbeda pada masing‑ masing – target bergeser ke atas dan ke kiri, persis seperti hasil pemindaian ulang:
Apa itu perbandingan gambar berbasis OCR?
Perbandingan gambar berbasis OCR membandingkan dua gambar berdasarkan teks yang diakui di dalamnya, bukan berdasarkan pikselnya. Setiap gambar dibaca oleh mesin pengenalan, dan urutan kata yang dihasilkan dibandingkan. Karena unit perbandingan adalah kata, bukan piksel, teks yang hanya bergeser posisi antara dua pemindaian dianggap tidak berubah, dan hanya perubahan kata yang sebenarnya dilaporkan sebagai perubahan.
Mengaktifkannya
Satu properti:
using var comparer = new Comparer("documents/source.png");
comparer.Add("documents/target.png");

comparer.Compare("Result/compared.png", new CompareOptions
{
    Ocr = new OcrOptions { Enabled = true },
    GenerateSummaryPage = false,
});

Console.WriteLine($"Changes: {comparer.GetChanges().Length}");
Itulah seluruh integrasi. Enabled secara baku false, sehingga setiap perbandingan
yang ada dalam basis kode Anda berperilaku persis seperti sebelumnya – bahkan jika
Anda secara tidak sengaja melewatkan instance OcrOptions tanpa mengaktifkannya.
Ada dua hal yang perlu diketahui sebelum menjalankannya. Persyaratan paketnya
adalah 26.10.0 atau lebih baru, karena fitur ini tidak ada sebelumnya. Dan ia memerlukan
target era .NET Core: mesin pengenalan menyediakan runtime aslinya hanya untuk
.NET Core dan versi selanjutnya, sehingga meminta OCR pada .NET Framework akan
menimbulkan NotSupportedException alih‑alih gagal secara tidak jelas di dalam mesin.
Apa yang tidak dibutuhkannya adalah paket kedua. Mesin OCR hadir sebagai
dependensi transitif dari GroupDocs.Comparison, jadi cukup dotnet add package
dan tidak ada yang lain.
Apa yang dikembalikan
Menjalankan potongan kode di atas terhadap dua rendering yang sengaja tidak sejajar dari halaman yang sama – satu dengan kata yang ditukar, satu baris ditulis ulang, satu baris dihapus, satu baris disisipkan, dan satu judul diubah dalam daftar isi – mengembalikan tujuh perubahan. Bukan tujuh ratus. Tujuh, dengan tingkat kepercayaan antara 0,97 dan 1,00:
Modified: 'alpha' -> 'gamma'                        (confidence 0.98)
Modified: 'is short.' -> 'has been rewritten ...'   (confidence 0.99)
Modified: 'five' -> 'six'                           (confidence 0.99)
Modified: 'heading' -> 'rewritten'                  (confidence 1.00)
Seluruh blok teks berada pada offset yang berbeda pada setiap halaman, dan tidak ada offset tersebut yang muncul dalam output. Sebuah kata yang hanya berpindah tetap menjadi kata yang sama.
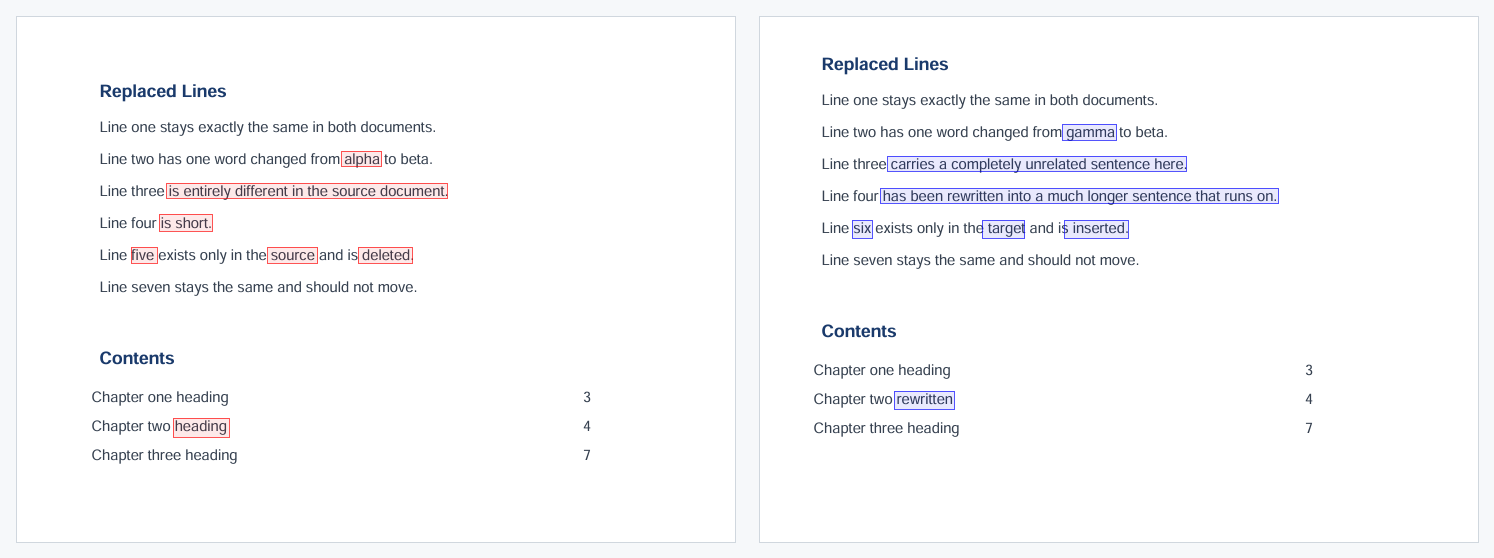
Kedua halaman mempertahankan tata letaknya masing‑masing, dan setiap kata yang berubah dibingkai di tempatnya: merah untuk apa yang dikatakan sumber, biru untuk apa yang dikatakan target. “Baris tujuh tetap sama dan tidak boleh berpindah” tidak ditandai di kedua sisi, meskipun posisinya berada pada jumlah piksel yang berbeda di setiap halaman.
Memilih cara hasil digambar
OcrDisplayMode memiliki dua nilai, dan pilihan tersebut berkaitan dengan audiens
bukan dengan perbandingan.
SideBySide adalah nilai baku. Ia menampilkan kedua halaman dalam tata letak
aslinya dan menandai masing‑masing di mana berbeda – font, tabel, kolom, dan gambar
tetap. Inilah yang diinginkan peninjau manusia: klausa yang berubah berada dalam
kontrak yang bersangkutan.
Ocr = new OcrOptions
{
    Enabled = true,
    DisplayMode = OcrDisplayMode.SideBySide,
},
Text merender kata‑kata yang dikenali dari kedua dokumen sebagai satu aliran
dengan penghapusan dan penyisipan yang disorot, tanpa meniru tata letak asli.
File hasilnya berukuran kira‑kira seperempat dari yang side‑by‑side pada contoh
eksekusi. Ini cocok untuk log audit, email ringkasan, atau situasi di mana
pilihan kata penting dan desain halaman tidak.
Ocr = new OcrOptions
{
    Enabled = true,
    DisplayMode = OcrDisplayMode.Text,
},
Tujuh edit yang sama dari dua gambar yang sama, digambar sebagai satu aliran – kata yang dihapus berwarna merah, kata yang disisipkan berwarna biru, berdekatan sehingga substitusi dapat dibaca sekilas:
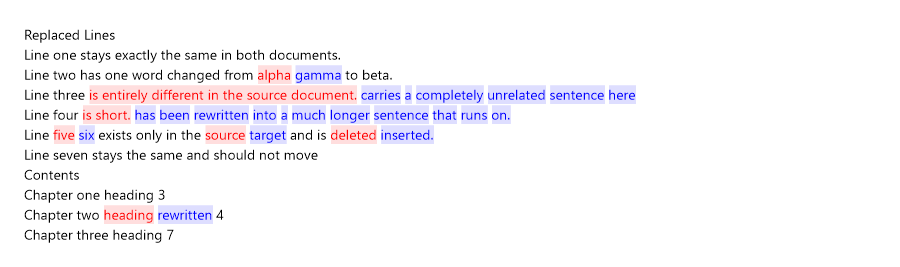
Kedua mode menemukan edit yang sama. Mode menentukan bagaimana hasil digambar, bukan apa yang ditemukan perbandingan – sebuah perbedaan yang penting dipertahankan, karena berarti Anda dapat mengubah format output tanpa harus memvalidasi kembali deteksi perubahan.
Bahasa
OcrLanguage memiliki 154 nilai. Alfabet tunggal (Deu, Rus, Jpn, Spa),
model seluruh skrip (Cyrillic, Chinese, Indic, PersoArabic), dan
Auto untuk deteksi ketika dokumen campuran atau tidak diketahui.
Ocr = new OcrOptions
{
    Enabled = true,
    Language = OcrLanguage.Cyrillic,
},
Bawaan adalah Latin, dan nilai bawaan ini penting secara operasional: Latin
adalah satu‑satunya model di dalam paket. Setiap nilai lain memerlukan model yang
diunduh dari repositori Aspose.OCR pada penggunaan pertama dan disimpan secara
lokal. Menamai skrip yang sebenarnya digunakan dokumen Anda akan membaca karakter
mereka lebih akurat daripada model umum, sehingga layak diatur bila Anda mengetahuinya.
Membaca di mana perubahan berada
Gambar side‑by‑side cukup ketika seseorang melihatnya. Ketika aplikasi menggambar overlay‑nya sendiri – UI peninjauan, alat redlining, penampil diff – ia memerlukan koordinat.
- itu membutuhkan koordinat.
foreach (ChangeInfo change in comparer.GetChanges())
{
    if (change is not OcrChangeInfo ocrChange)
    {
        continue;
    }

    Console.WriteLine($"{ocrChange.Type}: '{ocrChange.SourceText}'"
        + $" -> '{ocrChange.TargetText}'"
        + $" (confidence {ocrChange.Confidence:F2})");

    foreach (Rectangle box in ocrChange.TargetBoxes)
    {
        Highlight(box.X, box.Y, box.Width, box.Height);
    }
}
GetChanges() bertipe ChangeInfo[], sehingga detail OCR memerlukan cast ke
OcrChangeInfo. Subtipe itu menambahkan SourceBoxes dan TargetBoxes – satu
persegi panjang per baris teks, dalam piksel gambar sisi masing‑masing, dengan
koordinat float – serta Confidence dari 0 hingga 1.
Nilai kepercayaan lebih berguna daripada yang terlihat pada awalnya. Mencatatnya di samping setiap perubahan memungkinkan pipeline mengarahkan apa pun di bawah ambang batas ke peninjauan manual alih‑alih memperlakukan semua teks yang dikenali sebagai sama pasti.
Menjalankan tanpa jaringan
Agen build atau host yang terisolasi tidak boleh mencoba mengunduh model pengenalan secara tak terduga. Dua properti mencegah hal itu:
Ocr = new OcrOptions
{
    Enabled = true,
    Language = OcrLanguage.Latin,
    DisableResourceDownloads = true,
    ResourcesPath = "/opt/ocr-models",
},
DisableResourceDownloads mengubah model yang hilang menjadi error alih‑alih
pengunduhan yang menggantung atau ditolak. ResourcesPath menentukan folder
tempat model dibaca dan disimpan secara lokal.
Keduanya berlaku untuk seluruh proses, bukan hanya satu panggilan, jadi atur sekali saat startup alih‑alih pada setiap perbandingan – detail yang mudah terlewat ketika objek opsi dibangun per permintaan.
Teks Latin berfungsi offline tanpa persiapan apa pun, karena model itu sudah
termasuk dalam paket. Untuk skrip lain, salin folder model yang telah di‑cache
dari mesin yang pernah mengunduhnya dan arahkan ResourcesPath ke sana.
Menangani kegagalan yang layak ditangani
Ada dua mode kegagalan yang memerlukan penanganan eksplisit, bukan sekadar catch umum.
Yang pertama adalah pada platform. Jika jalur kode apa pun dapat mencapai
perbandingan OCR dari target .NET Framework, ia akan melempar NotSupportedException,
dan menangkapnya secara khusus memungkinkan Anda mencatat sesuatu yang dapat
ditindaklanjuti oleh pemelihara alih‑alih menampilkan stack trace dari dalam mesin.
Yang kedua adalah model yang tidak ada. Dengan DisableResourceDownloads diatur,
bahasa yang modelnya belum di‑cache akan gagal alih‑alih diunduh – itulah tujuan
pengaturan ini, tetapi hanya membantu bila error dapat dikenali. Mesin melaporkannya
melalui rantai exception, jadi periksa InnerException serta pesan luar ketika
menentukan apakah kegagalan terkait model atau perbandingan itu sendiri.
try
{
    comparer.Compare(outputPath, options);
}
catch (NotSupportedException)
{
    logger.LogError("OCR comparison needs a .NET Core-era runtime.");
    throw;
}
Tidak ada kasus yang eksotik. Yang pertama muncul ketika sebuah pustaka dibagi antara layanan modern dan host legacy; yang kedua, pada kali pertama penyebaran menjalankan di tempat yang cache belum disalin.
Catatan tentang kualitas gambar
Akurasi pengenalan menentukan batas atas akurasi perbandingan, dan tidak ada yang dalam perbandingan dapat memulihkan teks yang salah dibaca mesin. Pasangan contoh yang digunakan di sini bersih – teks yang dirender, kontras tinggi, tanpa kemiringan – dan menghasilkan nilai 0,97 hingga 1,00. Pemindaian nyata dari kertas lama tidak selalu mencapai itu.
Inilah argumen praktis untuk mencatat Confidence alih‑alih membuangnya.
Perubahan yang dilaporkan dengan 0,6 tidak serta‑merta salah, tetapi itu klaim
yang berbeda dibandingkan dengan 0,99, dan pipeline yang memperlakukan keduanya
secara identik pada akhirnya akan menampilkan artefak pengenalan sebagai edit
dokumen. Menetapkan ambang pada kepercayaan, dan mengarahkan yang di bawahnya ke
orang, tidak memakan biaya besar dan menjaga hal itu keluar dari output.
Kapan harus menggunakan ini
Perbandingan OCR adalah alat yang tepat ketika dokumen datang sebagai gambar dan pertanyaannya tentang pilihan kata: kontrak yang dipindai, faktur arsip, amandemen faks, tangkapan layar laporan dari dua build berbeda. Di mana saja dua rendering konten yang sama tidak akan sejajar pada tingkat piksel.
Ini bukan pengganti untuk membandingkan dokumen yang sudah berupa teks. Jika kedua sisi adalah DOCX atau PDF dengan lapisan teks nyata, bandingkan langsung – teks sudah ada, dan pengenalan hanya menambah langkah serta sumber kesalahan.
Mulailah dengan Enabled = true dan nilai baku, jalankan pada sepasang halaman
di mana Anda tahu apa yang berubah, dan periksa apakah jumlahnya cocok. Kemudian
tambahkan pemilihan bahasa dan penanganan koordinat sesuai kebutuhan aplikasi.